如果你在近两年接触过深度学习,几乎不可能绕过"注意力机制"这个词。它既是Transformer注意力机制的基石,也是当下大模型能够处理长文本、跨模态任务的关键组件。但很多初学者在看完几篇教程后仍有一个疑问:注意力到底在"注意"什么?它为什么能取代循环神经网络?工程上又该怎么用?本文从原理、演进、变体到落地实践,做一次系统的梳理。
一、注意力机制为什么会出现:一个信息瓶颈问题
注意力机制最早被广泛讨论,是在机器翻译任务中。2014年前后,主流的序列到序列(Seq2Seq)模型采用编码器—解码器结构:编码器把整句源语言压缩成一个固定长度的向量,解码器再从这个向量出发逐词生成译文。
这个设计有一个天然的缺陷:无论句子是5个词还是50个词,最终都要塞进同一个定长向量里。句子越长,信息损失越严重,长距离依赖几乎必然被稀释。这就是所谓的"信息瓶颈"。
注意力机制的思路非常直接:既然定长向量装不下,那就不装了。解码器在生成每一个词时,动态地去查看编码器的全部隐藏状态,并按照相关性分配权重——相关性高的位置权重更大,相关性低的接近忽略。这样一来,信息通道从"单条细管"变成了"随用随取的全连接",长距离依赖问题被大幅缓解。
这个思想后来被证明具有极强的普适性:不只是翻译,任何需要"从一堆信息中挑出当前最相关部分"的任务,都可以用注意力来建模。
二、拆开看:Query、Key、Value 三要素
理解注意力机制最有效的方式,是把它类比成一次"软性检索"。想象你在一个资料库里查资料:
- Query(查询):你当前想问的问题,代表"我现在需要什么信息"。
- Key(键):资料库里每条资料的索引标签,代表"我这条信息是关于什么的"。
- Value(值):资料的实际内容。
注意力的计算过程就是:拿Query去和每一个Key做匹配打分,把分数归一化成权重,再用这些权重对Value做加权求和。最终得到的是一个"按需定制的上下文向量"。
写成公式,核心就是三步:
- 打分:score = Q · KT,衡量查询与各个键的匹配程度;
- 归一化:α = softmax(score / √dk),把分数变成和为1的概率分布;
- 聚合:output = α · V,按权重融合信息。
其中 √dk 这个缩放因子常被忽略,但它很关键。当维度较大时,点积结果的方差会随之增大,softmax 容易被推向极端值,导致梯度几乎消失。除以维度的平方根,本质上是把打分重新拉回一个数值稳定的区间。
三、打分函数的演进:加性注意力与乘性注意力
在注意力机制的发展过程中,出现过几种不同的打分方式,理解它们有助于看清设计取舍:
- 加性注意力(Bahdanau 注意力):把 Q 和 K 拼接后送入一个小型前馈网络输出分数。表达能力强,适合 Q、K 维度不一致的场景,但计算开销相对大。
- 乘性注意力(Luong 注意力):直接用点积或双线性变换计算分数。实现简单、可以利用高度优化的矩阵乘法,在现代硬件上效率优势明显。
- 缩放点积注意力:乘性注意力的稳定化版本,也是 Transformer注意力机制 采用的标准形式。
从工程角度看,最终胜出的是缩放点积,原因不是它理论最优,而是它对 GPU 友好——注意力的大部分计算可以归约为批量矩阵乘法,这正是现代加速器最擅长的操作。
四、自注意力、交叉注意力与多头注意力
根据 Q、K、V 的来源不同,注意力衍生出几种常见形态,很多人容易混淆,这里做个区分:
- 自注意力(Self-Attention):Q、K、V 都来自同一个序列。序列中每个位置都能直接与其它所有位置交互,一步建立全局依赖,不需要像 RNN 那样逐时间步传递。这是 Transformer 编码器的核心。
- 交叉注意力(Cross-Attention):Q 来自一个序列(如解码器),K、V 来自另一个序列(如编码器输出)。它是"读"另一段信息的手段,在多模态模型中尤为常见,比如让文本查询去对齐图像特征。
- 掩码注意力(Masked Attention):在自回归生成中,通过上三角掩码屏蔽未来位置,保证模型在预测第 t 个词时只能看到前 t-1 个词。这是解码器能够合理训练的前提。
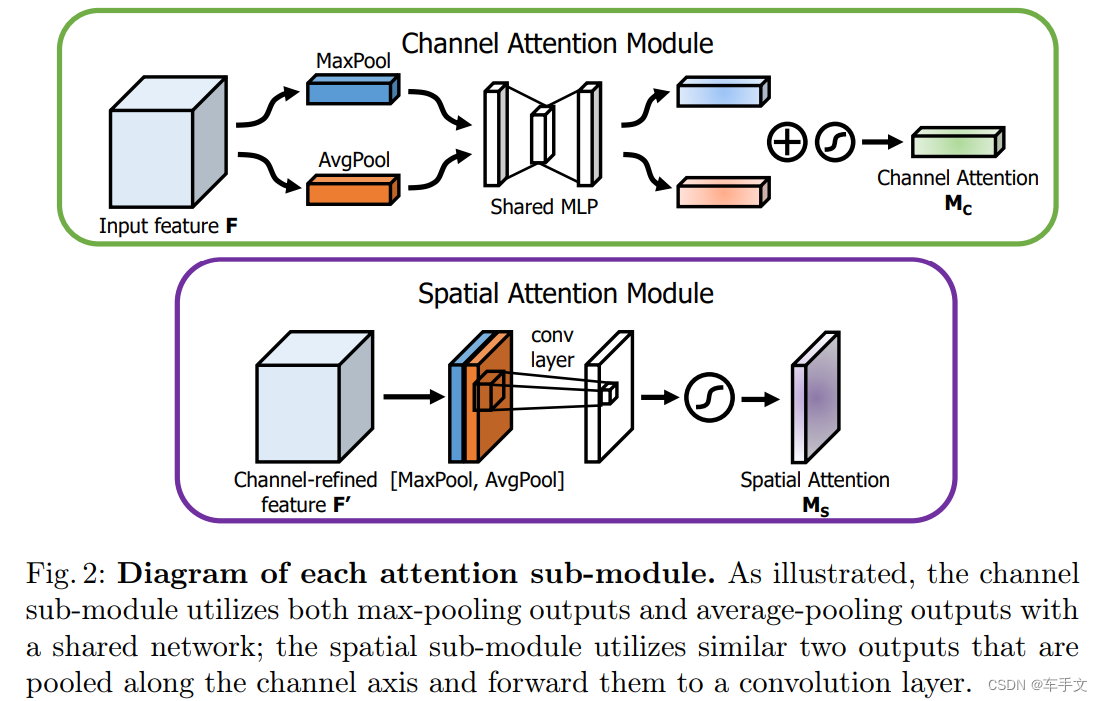
- 多头注意力(Multi-Head Attention):把表示空间切分成若干个子空间,每个头独立做一次注意力,最后拼接并线性变换。不同头可以关注不同类型的关系——有的偏向语法邻接,有的偏向语义共指,有的捕捉长距离位置模式。多头的意义在于让模型在多个子空间中并行地"看"同一段输入。
五、Transformer注意力机制:一次架构层面的重构
2017年的《Attention Is All You Need》做了一件激进的事:把循环和卷积全部拿掉,只用注意力堆叠出完整架构。这一改动的连锁反应非常深远。
首先是并行性。RNN 必须按时间步串行计算,序列越长越慢;而注意力对整句是一次性矩阵运算,训练时可以充分并行,这让在超大规模数据上训练成为可能。
其次是路径长度。在 RNN 中,相距 n 个位置的两个词需要经过 n 步传递才能建立联系;在自注意力中,任意两位置之间的交互路径长度恒为 1。梯度传播路径短,长距离依赖的学习难度显著下降。
代价也很明确:自注意力的计算与显存复杂度是 O(n²d),序列长度翻倍,开销约变成四倍。这直接催生了后面一系列效率优化研究,也是长上下文模型必须面对的核心矛盾。此外,自注意力本身不含位置信息,需要额外引入位置编码(正弦编码、可学习编码或 RoPE 等旋转位置编码)来补足顺序感。
六、效率优化:从稀疏注意力到线性注意力
既然 O(n²) 是瓶颈,优化方向自然分成几条路线:
- 稀疏与局部注意力:假设大部分注意力权重并不重要,只计算局部窗口或固定模式,降低实际计算量。
- 线性注意力:通过核函数近似重构计算顺序,把复杂度降到 O(nd²),让长序列变得可行。
- IO 感知优化:FlashAttention 一类工作不改数学形式,而是通过分块计算与显存层级优化,减少 GPU 高带宽内存的读写次数。实践中最常见的提速往往来自这一层。
- KV Cache 与缓存压缩:推理阶段缓存键值对避免重复计算,同时用分组查询注意力(GQA)、多查询注意力(MQA)压缩缓存体积,这在部署大模型时几乎是标配。
对大多数业务团队来说,优先级建议是:先做推理侧的 KV Cache 与量化,再考虑架构级替换。架构改动成本高,收益需要具体任务验证。
七、注意力机制在各领域的实际落地
注意力早已不是 NLP 专属,它在多个方向上都成为了基础设施。
信息检索技术
传统检索依赖 BM25 这类稀疏词频方法,优点是快、可解释,缺点是无法理解语义。引入注意力后,出现了稠密检索(如双塔编码器把查询和文档映射到同一向量空间)和后期交互模型(如 ColBERT,用 MaxSim 计算查询词与文档词的细粒度匹配)。两者结合的多路召回加重排序架构,已经成为现代搜索系统的常见形态。注意力在这里承担的角色,是把"关键词匹配"升级为"语义匹配"。
计算机视觉与多模态
ViT 把图像切成 patch 当作 token 输入 Transformer,DETR 用注意力做目标检测的集合预测,Swin 通过窗口划分兼顾局部性与全局建模。在图文任务中,交叉注意力负责把视觉特征与文本 token 对齐,是图文生成、视觉问答的核心组件。
强化学习与仿真训练
在强化学习领域,注意力被用于处理变长观测、多智能体协作以及部分可观测场景下的记忆建模。决策 Transformer 直接把轨迹当作序列建模,用注意力替代传统价值函数。这类方法在仿真环境中验证成本较低——例如在 AirSim 仿真 这类无人机仿真平台中,智能体可以在虚拟环境里反复试错,用注意力结构处理多传感器输入的时序对齐问题,再迁移到真实设备。相比真机测试,仿真能大幅降低试错成本与硬件损耗,这也是无人机仿真平台近年被大量使用的原因。
与元学习算法的交叉
元学习算法关注的是"如何快速适应新任务"。注意力天然适合这个目标:把历史任务的经验存成键值对,面对新任务时用查询去检索最相关的经验,从而实现少样本快速适配。记忆增强网络、注意力神经过程等都属于这一思路。可以说,注意力提供了一种可微的、端到端的外部记忆访问机制。
八、动手实践:从深度学习入门到工程落地
理论看懂了,真正写出能跑的注意力模块,往往还会踩不少坑。以下是一条相对平滑的实践路径:
- 先手写一遍缩放点积注意力:不调用现成库,用基础张量操作实现 Q、K、V 计算与掩码处理。这一步能帮你彻底搞清维度变换与 mask 的广播规则。
- 再实现多头注意力:重点是理解如何用一次 reshape 把多头合并进批量维度,避免写出低效的 for 循环。
- 搭一个迷你 Transformer:做个小规模翻译或文本分类任务,观察位置编码缺失、学习率设置不当会带来什么现象。
- 借助成熟教程加速:像 Fast.ai教程 这类自顶向下的材料,适合在动手之后再回头补理论,学习曲线比纯理论推导友好得多。计算机科学基础扎实的读者也可以直接读原始论文与开源实现,对照理解。
- 结合业务场景验证:注意力不是万能药。数据量小、序列短、任务简单的场景,传统模型可能更稳。先做基线对比,再决定是否引入。
九、几个常见误区
- "注意力权重就是可解释性":注意力权重能提供参考,但已有研究指出它未必等价于真实的因果重要性。把它当作可视化诊断工具可以,当作结论依据需谨慎。
- "层数越多效果越好":在数据有限的情况下,过深的注意力堆叠容易过拟合,且训练不稳定。层数应与数据规模和任务复杂度匹配。
- "替换成线性注意力一定更快":线性注意力在短序列上优势不明显,甚至因实现开销而变慢。是否采用要看实际序列长度分布。
- "注意力可以完全替代其它结构":卷积的局部归纳偏置、循环的时序先验,在特定任务上仍有价值。混合架构往往比纯注意力更实用。
十、结语
注意力机制的价值,本质上来自它解决了一个根本问题:让模型在面对大量信息时,能够动态、可微地决定该看哪里、看多少。从 Seq2Seq 的信息瓶颈,到 Transformer注意力机制 的全面铺开,再到信息检索技术、强化学习、元学习算法等方向的交叉渗透,这条脉络始终清晰。
对技术团队而言,理解注意力不只是跟上一个热门概念,更关系到能否在搜索、推荐、多模态、智能决策等真实业务中把模型用对。创智数据科技长期关注信息传输与软件信息技术服务领域的技术演进,在人工智能应用开发、系统集成与工程落地方面积累了实践经验。如果你正在规划涉及注意力机制或深度学习入门相关的项目,欢迎通过 bdbfc.com 与我们交流探讨,一起把技术方案落到可运行的系统中去。