在当今信息传输、软件和信息技术服务业高速发展的背景下,人工智能技术正以前所未有的速度渗透到软件开发、系统集成、大数据分析、云计算平台建设等各个技术服务领域。而在这一切智能应用的底层,注意力机制(Attention Mechanism)无疑是最具革命性的技术突破之一。从自然语言处理到计算机视觉,从强化学习到无人机仿真平台,注意力机制正在重塑深度学习的技术格局。本文将围绕注意力机制的核心原理、Transformer架构中的关键作用、与元学习算法的协同、在信息检索技术中的应用,以及面向Fast.ai教程学习者和AirSim仿真开发者的实践路径展开深入探讨,帮助读者建立从计算机科学基础到深度学习入门的完整认知框架。
一、注意力机制的本质:让模型学会“选择性关注”
注意力机制的核心思想并不复杂:在面对大量信息时,模型应当具备“选择性关注”的能力,将有限的计算资源分配给最重要的部分。这一理念借鉴了人类认知系统的工作方式——当我们阅读一段文字或观察一幅图像时,并不会对每个细节投入同等的注意力,而是聚焦于关键信息。
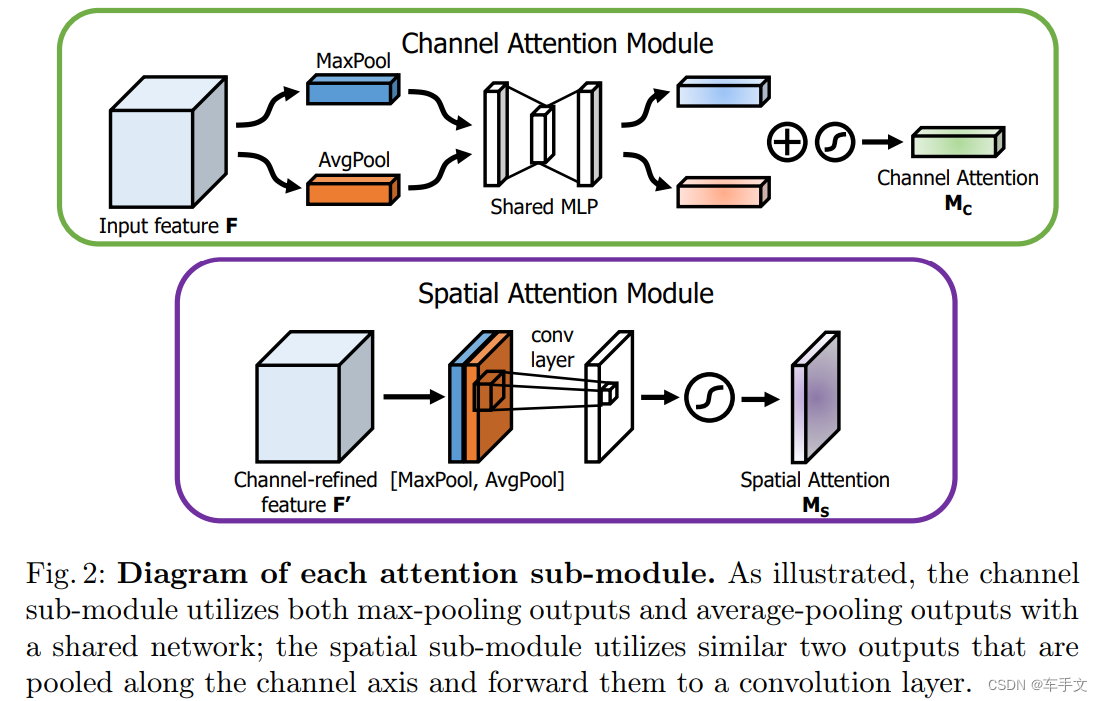
从技术实现角度看,注意力机制通常涉及查询(Query)、键(Key)和值(Value)三要素。模型通过计算查询与各个键之间的相似度得分,再经归一化处理得到注意力权重,最终对值进行加权求和。这一过程使模型能够动态地决定“看哪里”和“看多少”,从而显著提升信息处理的效率和准确性。
在信息传输与互联网技术服务领域,注意力机制的价值尤为突出。无论是搜索引擎对用户查询意图的理解,还是推荐系统对海量内容的筛选排序,注意力机制都能帮助系统从噪声中提取信号,实现更精准的信息匹配。
二、Transformer注意力机制:架构层面的范式变革
2017年提出的Transformer架构,将注意力机制推向了舞台中央。与传统循环神经网络(RNN)和卷积神经网络(CNN)不同,Transformer完全依赖自注意力(Self-Attention)来捕捉序列中的长距离依赖关系。这一设计带来了三个显著优势:
- 并行计算能力:自注意力机制允许序列中所有位置同时计算,大幅提升了训练效率,这对云计算平台上的大规模模型训练至关重要。
- 长距离依赖建模:无论两个位置相距多远,自注意力都能直接建立联系,避免了RNN中信息逐层传递导致的衰减问题。
- 多头注意力设计:通过多个注意力头并行捕捉不同子空间的特征,模型能够从多个维度理解输入信息,增强了表达能力。
Transformer注意力机制的影响早已超越自然语言处理领域。在计算机视觉中,Vision Transformer(ViT)将图像切分为 patches 后用自注意力处理;在语音识别、时序预测、代码生成等任务中,Transformer同样展现出强大的通用性。对于从事软件开发和系统集成的技术团队而言,理解Transformer注意力机制已成为构建现代智能应用的基础能力。
三、注意力机制与元学习算法的协同效应
元学习算法(Meta-Learning)旨在让模型“学会学习”,即通过少量样本快速适应新任务。注意力机制与元学习算法的结合,催生了一系列重要的技术进展。例如,在少样本学习场景中,模型可以利用注意力机制对支持集样本进行加权聚合,从而更有效地提取任务相关的特征表示。
这种协同在技术服务领域有广泛的应用前景。以智能运维为例,系统需要在面对新型故障时快速适应,元学习提供了快速泛化的框架,而注意力机制则帮助系统聚焦于故障信号中的关键特征。再比如在个性化推荐系统中,元学习算法可以根据用户行为快速调整推荐策略,注意力机制则负责从用户历史行为中筛选出最相关的信息。两者的结合,使得系统在数据稀缺或任务多变的场景下依然保持稳健表现。
四、信息检索技术中的注意力机制应用
信息检索技术是互联网技术服务的核心组成部分,而注意力机制在这一领域的应用已经相当成熟。传统检索模型主要依赖关键词匹配和统计特征,难以深入理解查询与文档之间的语义关联。引入注意力机制后,检索系统可以实现以下提升:
- 查询理解增强:通过自注意力对查询词进行上下文编码,准确捕捉多义词和长尾查询的真实意图。
- 文档相关性建模:利用交叉注意力计算查询与文档之间的细粒度匹配信号,替代粗粒度的整体相似度计算。
- 结果重排序优化:在召回阶段之后,使用基于Transformer的排序模型对候选结果进行精细化打分,显著提升检索质量。
对于从事大数据平台和搜索引擎开发的技术人员来说,掌握注意力机制在信息检索中的应用方法,是构建高质量检索服务的关键。当前主流的稠密检索(Dense Retrieval)方案,几乎都建立在Transformer注意力机制的基础之上。
五、从理论到实践:Fast.ai教程与AirSim仿真的学习路径
对于希望系统掌握注意力机制和深度学习入门知识的开发者,Fast.ai教程提供了一条自顶向下的高效学习路径。与传统“先理论后实践”的教学方式不同,Fast.ai强调先让学习者动手训练模型,再逐步深入底层原理。在Fast.ai的课程体系中,Transformer和注意力机制是重要的进阶内容,学习者可以通过实际代码理解自注意力的计算流程、多头注意力的实现细节以及位置编码的作用。
与此同时,对于关注无人机仿真平台和强化学习方向的开发者,AirSim仿真环境提供了一个理想的实验场所。在基于AirSim的无人机控制研究中,注意力机制常被用于处理多传感器融合数据——例如将视觉图像、激光雷达点云和惯性测量数据通过注意力加权整合,帮助飞行控制策略聚焦于最关键的感知信息。结合强化学习训练框架,研究者可以构建端到端的飞行决策模型,而注意力机制在其中扮演着感知信息筛选与特征融合的核心角色。
建议的学习路线如下:
- 先通过Fast.ai教程建立深度学习入门基础,理解神经网络训练的基本流程;
- 深入学习Transformer注意力机制的数学原理与代码实现;
- 在信息检索或自然语言处理任务中实践注意力模型;
- 结合AirSim仿真平台,将注意力机制应用于强化学习驱动的无人机控制实验;
- 探索元学习算法与注意力机制的融合方案,提升模型在少样本场景下的适应能力。
六、注意力机制在行业技术服务中的落地前景
回到信息传输、软件和信息技术服务业的行业语境,注意力机制的应用远不止于学术研究。在软件开发层面,基于Transformer的代码补全和缺陷检测工具正在改变开发流程;在系统集成层面,注意力机制驱动的多模态融合方案为复杂系统的智能监控提供了新思路;在云计算平台层面,注意力机制被用于资源调度预测和异常流量检测;在安全运维层面,基于自注意力的日志分析模型能够从海量事件中精准定位安全威胁。
可以预见,随着深度学习入门门槛的降低和Fast.ai教程等优质学习资源的普及,越来越多的技术团队将有能力把注意力机制应用到实际项目中。而Transformer注意力机制、元学习算法与强化学习的交叉融合,也将在无人机仿真平台、智能信息检索、自动化运维等场景中持续释放技术红利。对于计算机科学基础扎实、愿意深入理解注意力机制原理的开发者而言,这无疑是一个充满机遇的技术方向。