在信息传输、软件和信息技术服务业高速演进的今天,人工智能已经从实验室走向大规模工程落地。而在众多支撑智能系统的底层技术中,注意力机制无疑是最具变革性的思想之一。它不仅重塑了自然语言处理的格局,还渗透到计算机视觉、强化学习、信息检索乃至无人机仿真等多元场景。对于从事软件开发、系统集成与大数据服务的团队而言,理解注意力机制的来龙去脉,已成为构建高性能智能平台的基础功课。本文将从原理、架构、应用与工程实践等角度,系统梳理这一关键技术的全貌。
注意力机制的本质:让模型学会“有所取舍”
传统神经网络在处理序列信息时,往往对所有输入一视同仁,导致关键信息被淹没在噪声之中。注意力机制的核心思想,就是赋予模型一种动态加权的能力:面对一组输入,模型能够自动判断哪些部分更值得关注,并为其分配更高的权重。这种“有所取舍”的机制,与人类阅读时聚焦关键词、忽略冗余信息的认知过程高度相似。
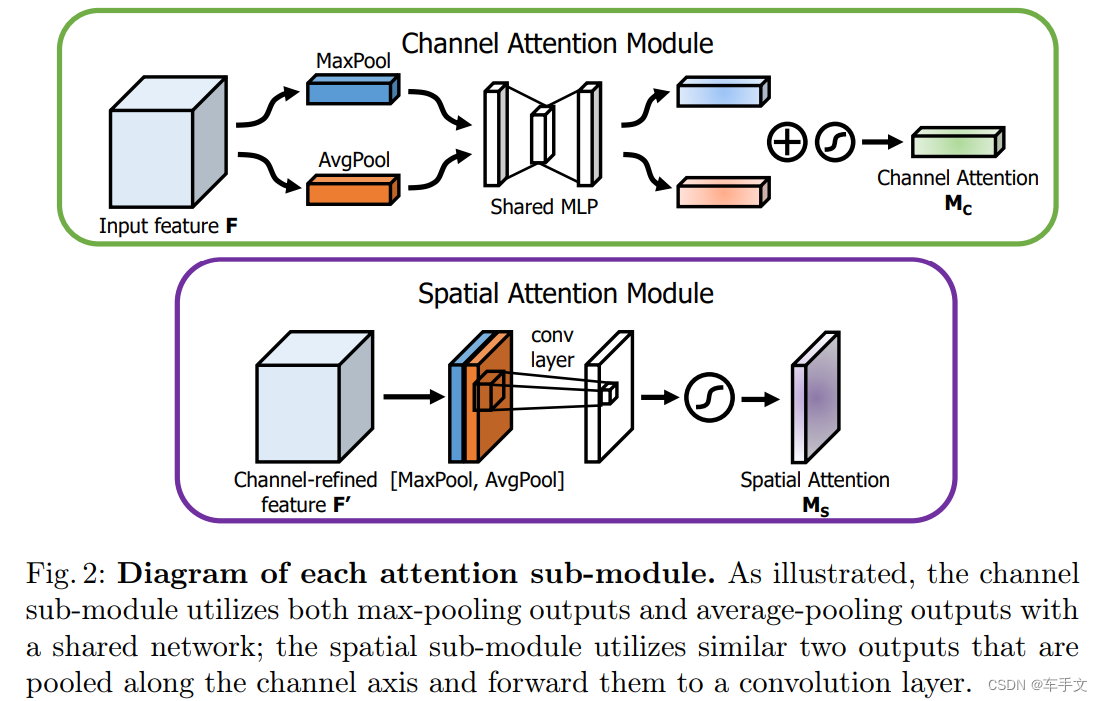
从数学角度看,注意力通常由查询(Query)、键(Key)与值(Value)三要素构成。模型通过计算查询与各个键的相似度,得到一组归一化的权重,再对值进行加权求和,从而输出聚焦后的表示。这一过程可微、可训练,能够端到端地嵌入到深度网络之中,这也是它相比传统规则式特征选择方法的根本优势。
- 软注意力:以概率分布的形式对全部输入加权,平滑但计算量随序列长度增长。
- 硬注意力:直接选取部分输入,计算更省但不可微,常需借助强化学习训练。
- 自注意力:序列内部元素互相关注,是Transformer架构的基石。
- 交叉注意力:在两个不同序列之间建立关联,广泛用于机器翻译与多模态融合。
Transformer注意力机制:并行化带来的范式跃迁
如果说注意力机制是一颗种子,那么Transformer注意力机制就是让它长成参天大树的土壤。循环神经网络依赖时序递推,难以并行,长距离依赖也容易衰减;而Transformer完全抛弃循环结构,仅依靠多头自注意力与前馈网络堆叠,实现了对序列的全局建模。
多头注意力的设计尤为巧妙:它将查询、键、值投影到多个子空间,各自独立计算注意力后再拼接。不同的“头”可以捕捉不同类型的依赖关系,有的关注局部搭配,有的捕捉远距离指代,从而让模型具备更丰富的表达能力。配合位置编码、残差连接与层归一化,Transformer在训练稳定性和扩展性上都表现出色,成为大模型时代的通用骨架。
在实际的软件开发与平台建设中,Transformer的价值不仅体现在算法效果上,更体现在工程可扩展性上。其结构规整、易于张量并行与流水线并行,能够借助GPU集群高效训练,这与云计算与大数据基础设施的发展相辅相成。对于提供系统集成与技术支持的服务商来说,围绕Transformer构建推理服务、模型压缩与部署流水线,已经成为一项重要的技术能力。
注意力机制在信息检索技术中的落地
信息检索技术是注意力机制最早受益的领域之一。传统检索依赖词频与倒排索引,难以理解语义层面的相关性。引入注意力后,检索系统可以对查询与文档进行交互式建模:查询中的每个词与文档中的每个片段相互计算注意力权重,从而判断哪些段落真正回应了用户意图。
在向量检索与语义搜索场景中,基于Transformer的双塔或交叉编码器能够将查询和文档映射到统一语义空间,显著提升召回与排序质量。结合倒排索引与近似最近邻搜索,可以在海量数据下兼顾效率与精度。对于互联网平台与大数据服务企业而言,这套组合已成为构建智能搜索、推荐与知识库问答系统的标准方案。
- 查询理解:利用注意力识别查询中的核心实体与意图词。
- 文档排序:交叉注意力精细刻画查询—文档相关性。
- 摘要抽取:注意力权重可解释性强,便于定位关键句。
- 多路召回融合:不同粒度注意力结果加权整合,提升鲁棒性。
元学习算法与注意力机制的协同
元学习算法关注的是“学会学习”,即让模型在少量样本下快速适应新任务。注意力机制在此扮演了重要角色:元学习模型需要从支持集中提取与当前查询最相关的经验,而注意力恰好提供了一种可微的加权检索方式。典型做法是将支持样本编码为键值记忆,查询样本通过注意力读取记忆,从而完成少样本分类或回归。
这种协同在工业场景中颇具价值。例如在设备故障诊断、用户意图识别等任务中,新类别不断出现而标注样本稀缺,元学习加注意力的组合能够显著降低重新训练成本。对于提供运维与技术支持服务的企业,这意味着更快的模型迭代周期与更低的定制化门槛。
强化学习与无人机仿真平台中的注意力应用
强化学习处理的是序列决策问题,智能体需要在纷繁的观测信息中抓住关键线索。注意力机制可以帮助智能体对状态特征进行筛选,聚焦与当前决策最相关的部分,从而提升样本效率与策略稳定性。在多智能体环境中,注意力还被用于建模智能体之间的交互关系,判断应当关注哪些同伴的行为。
在无人机仿真平台如AirSim中,这一思想体现得尤为直观。仿真环境提供丰富的视觉与传感器数据,智能体需要从中提取障碍物、目标与地形信息。借助注意力网络,飞行策略可以有选择地关注视野中的关键区域,在避障与路径规划任务中表现更稳健。配合计算机科学基础中的数据结构与算法知识,开发者能够在仿真中快速验证想法,再迁移到真实平台。
对于希望系统入门的学习者,Fast.ai教程提供了自顶向下的实践路径,可以先跑通注意力模型的训练流程,再回溯理论细节。结合深度学习入门阶段的线性代数与概率基础,逐步理解注意力权重的计算逻辑,是一条行之有效的学习路线。
工程实践建议:把注意力机制用对、用好
注意力机制虽好,但并非万能。工程落地时需要结合具体业务权衡成本与收益。以下几点经验值得参考:
- 数据规模匹配:注意力模型参数量大,小数据场景应优先考虑预训练加微调,或采用轻量注意力变体。
- 计算资源规划:长序列注意力的复杂度随长度平方增长,可借助稀疏注意力、线性注意力或分块计算降低开销。
- 可解释性利用:注意力权重可作为调试与审计的辅助信号,但不宜直接等同于因果解释。
- 部署优化:推理阶段可采用算子融合、量化与蒸馏,配合云平台弹性调度,平衡延迟与成本。
- 持续评估:建立覆盖准确率、延迟与稳定性的监控体系,避免模型漂移影响线上服务。
从信息传输到云计算平台,从智能搜索到仿真系统,注意力机制正在成为连接算法与业务的通用纽带。创智数据科技持续关注注意力机制、Transformer架构、元学习与强化学习等前沿方向,致力于为软件开发、系统集成与技术服务体系提供扎实的算法支撑与工程实践参考。理解注意力,就是理解当代智能系统如何从海量信息中提炼价值的第一步。