在信息传输、软件和信息技术服务业高速演进的今天,人工智能已从实验室走向大规模工程落地。无论是云计算平台上的大数据分析,还是智能软件开发中的语义理解,注意力机制(Attention Mechanism)都扮演着越来越关键的角色。它让模型学会"抓重点",在海量信息中快速定位最有价值的片段。本文将从注意力机制的基本原理出发,结合Transformer注意力机制、元学习算法、信息检索技术、Fast.ai教程、AirSim仿真、深度学习入门、强化学习与无人机仿真平台等关键词,系统梳理这一技术的工程价值与学习路径,帮助技术团队建立完整的认知框架。
注意力机制到底是什么:从"平均看待"到"重点聚焦"
传统的神经网络在处理序列信息时,往往对输入的各部分一视同仁,或者仅依靠固定窗口的上下文。注意力机制的核心思想,是让模型在处理某个目标时,动态地为输入的不同部分分配不同权重。通俗地说,就是"看哪里更重要,就把更多注意力放在哪里"。
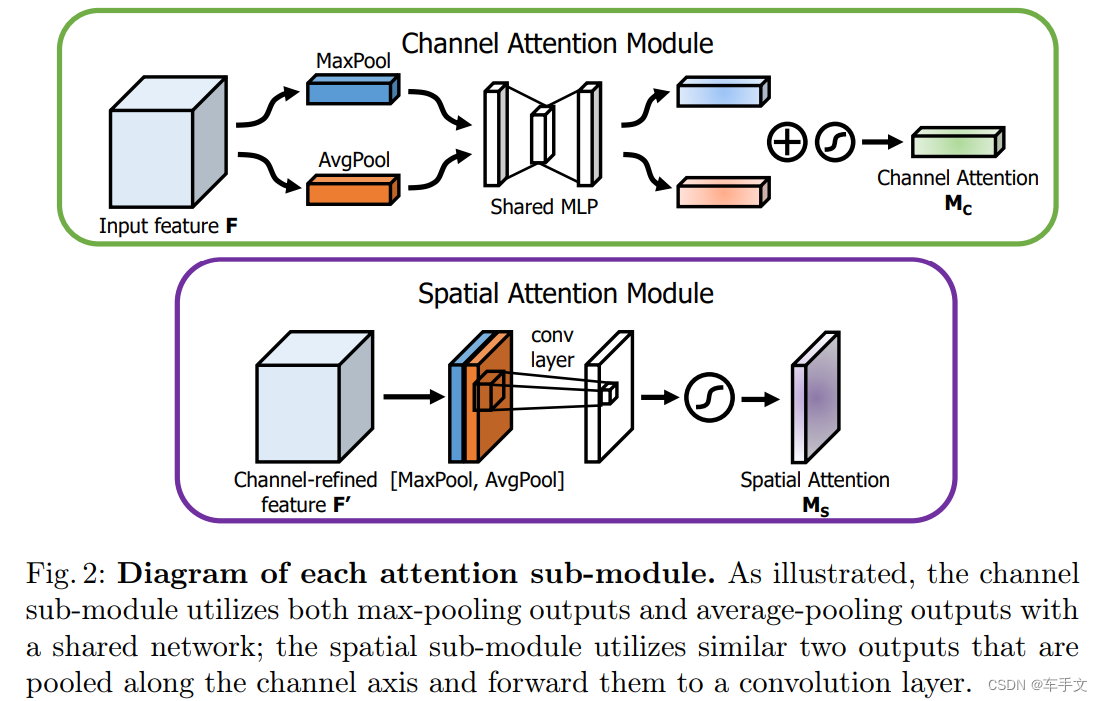
从计算角度看,注意力机制通常包含查询(Query)、键(Key)、值(Value)三个要素:通过查询与键的相似度计算权重,再对值进行加权求和。这种设计带来三个直接好处:
- 可解释性增强:注意力权重可以可视化,帮助工程师理解模型决策依据;
- 长距离依赖建模:不再受限于循环结构的逐步传递,信息可以直接跨距离关联;
- 并行计算友好:矩阵运算天然适配GPU加速,契合云计算与大规模系统集成需求。
对于从事软件开发、平台建设与信息技术服务的企业而言,理解注意力机制不仅是算法层面的知识,更是构建智能检索、智能客服、内容推荐等业务系统的基础能力。
Transformer注意力机制:现代深度学习架构的基石
Transformer 架构将注意力机制推向舞台中央。它完全抛弃了循环结构,依靠自注意力(Self-Attention)与多头注意力(Multi-Head Attention)捕捉序列内部关系。多头机制的意义在于:不同的"头"可以关注不同类型的关系模式,有的关注局部搭配,有的关注全局语义,最终拼接融合,形成更丰富的表示。
Transformer 注意力机制在工程实践中的价值主要体现在:
- 信息检索技术升级:基于Transformer的语义向量模型,可将查询与文档映射到同一语义空间,显著提升检索召回与排序质量;
- 多模态扩展:视觉-语言模型通过交叉注意力对齐图像与文本,为智能运维、安防监控等场景提供支撑;
- 系统集成便利:主流深度学习框架均提供成熟的注意力算子,便于在平台层快速封装为可复用服务。
需要注意的是,Transformer 的计算复杂度随序列长度平方增长,实际部署时需结合稀疏注意力、分块计算等优化手段,这也是信息技术服务中"性能调优"环节的重要课题。
注意力机制与元学习算法的协同:让模型"学会学习"
元学习算法关注的是"如何让模型快速适应新任务",而注意力机制恰好为这种快速适应提供了有效工具。在少样本学习场景中,模型可以通过注意力对支持集样本进行加权聚合,从而在仅有少量标注数据时也能做出合理预测。
两者结合的典型思路包括:
- 用注意力机制对任务间的特征进行选择性迁移,避免负迁移;
- 在元训练阶段引入注意力门控,动态调整不同任务对参数更新的贡献;
- 将注意力权重作为任务相似度的度量,辅助任务聚类与模型路由。
对于提供大数据与人工智能服务的企业,这类方法在冷启动推荐、小样本故障诊断、快速定制化模型交付等业务中具有现实意义,也能有效降低项目前期的数据采集成本。
从深度学习入门到Fast.ai教程:注意力机制的实践学习路径
很多初学者面对注意力机制的公式会感到抽象。实际上,借助高质量的教程与动手项目,理解门槛可以大幅降低。Fast.ai教程以"自顶向下"的教学理念著称,主张先跑通完整项目,再逐步深入原理,这与注意力机制的学习非常契合。
建议的学习路径如下:
- 第一阶段(深度学习入门):掌握张量运算、梯度下降与基础网络结构,理解权重更新的直觉;
- 第二阶段(注意力专题):动手实现缩放点积注意力与多头注意力,观察权重矩阵的变化;
- 第三阶段(Fast.ai教程实践):借助现成框架完成文本分类或语义匹配任务,体会注意力在真实数据上的作用;
- 第四阶段(信息检索技术融合):将语义向量接入检索系统,评估召回率与排序指标。
需要强调的是,计算机科学基础仍然不可跳过。线性代数中的矩阵乘法、概率论中的分布与期望,都是理解注意力计算的底层支撑。基础扎实,学习曲线才会平缓。
注意力机制在强化学习与无人机仿真平台中的应用
强化学习解决的是智能体在环境中通过试错获得最优策略的问题。当状态空间复杂、观测信息冗余时,注意力机制可以帮助智能体聚焦关键状态特征,提升策略学习的稳定性与样本效率。
在无人机仿真平台的实际应用中,这一组合尤为典型。以AirSim仿真为例,无人机需要根据视觉观测做出飞行决策,注意力机制可用于:
- 从高维图像观测中提取关键区域,降低策略网络输入维度;
- 在多传感器融合时动态分配权重,平衡视觉、惯性等不同信息源;
- 辅助强化学习训练过程中的信用分配,让智能体明确"哪一步观测导致了奖励变化"。
这类仿真驱动的研发模式,正成为信息技术服务中"系统集成+智能算法"交付的重要形态。通过在AirSim仿真中反复验证,团队可以在低成本、低风险的前提下迭代算法,再迁移到真实设备,显著缩短研发周期。
面向行业落地的工程建议
结合信息传输、软件和信息技术服务业的业务特点,团队在引入注意力机制时可以从以下几点着手:
- 明确业务目标:先判断问题是否真的需要注意力建模,避免为技术而技术;
- 重视数据治理:注意力权重的质量高度依赖输入数据质量,大数据平台的数据清洗与标注规范是前提;
- 关注部署成本:在云计算环境中合理选择模型规模,结合推理加速与缓存策略控制成本;
- 建立评估体系:对信息检索类应用,应同时关注准确率、召回率与响应时延;
- 持续学习迭代:跟踪Transformer注意力机制与元学习算法的新进展,保持技术栈更新。
注意力机制并非万能钥匙,但它是当前智能系统不可或缺的组成部分。从深度学习入门到强化学习落地,从信息检索技术到无人机仿真平台,理解并善用注意力机制,能够帮助技术团队在软件开发、平台建设与系统集成等业务中构建更聪明、更高效的智能服务。创智数据科技将持续围绕注意力机制、Transformer注意力机制、元学习算法等方向输出技术内容,与行业伙伴共同推进人工智能工程化实践。