在深度学习与人工智能快速演进的今天,"注意力机制"(Attention Mechanism)已经成为支撑大模型、自然语言处理、计算机视觉乃至强化学习的关键技术底座。无论是ChatGPT背后的Transformer架构,还是图像识别中的视觉注意力网络,抑或是无人机仿真平台中的决策优化,注意力机制都扮演着不可替代的角色。本文将结合信息传输、软件开发与人工智能技术服务的行业背景,系统梳理注意力机制的原理、演进、应用与学习路径,帮助计算机科学学习者与工程实践者建立完整的知识框架。
一、注意力机制到底是什么:从人类认知到数学建模
注意力机制的灵感来源于人类的认知过程。当我们阅读一段文字或观察一幅图像时,并不会对全部信息平均用力,而是会有选择地聚焦于关键部分,忽略次要信息。深度学习中的注意力机制正是对这一行为的数学抽象:它通过计算查询(Query)与键(Key)之间的相关性,得到一组权重,再对值(Value)进行加权求和,从而让模型"学会"把计算资源集中在最重要的信息上。
用公式表达,缩放点积注意力可以写作:
- 先计算 Q 与 K 的点积,衡量相似度;
- 除以维度的平方根进行缩放,避免梯度消失;
- 经 Softmax 归一化为概率分布;
- 最后与 V 相乘,得到加权后的上下文表示。
这套看似简洁的计算,解决了传统循环神经网络(RNN)在长序列建模中"记不住远处信息"的痛点,也让并行计算成为可能,为后续大规模模型的训练奠定了基础。
二、Transformer注意力机制:架构革命的核心引擎
2017年发表的《Attention Is All You Need》提出了Transformer架构,彻底改变了序列建模的范式。Transformer注意力机制的核心创新在于完全抛弃了循环结构,仅依靠自注意力(Self-Attention)与多头注意力(Multi-Head Attention)完成信息交互。
1. 自注意力与多头机制
自注意力让序列中的每个位置都能直接与其他所有位置建立联系,捕捉长距离依赖。而多头注意力则将输入映射到多个子空间,分别计算注意力后再拼接,使模型能够同时关注语法结构、语义关联、位置信息等不同维度的特征。这种"多视角并行"的设计,是Transformer表达能力强的重要原因。
2. 位置编码与残差连接
由于自注意力本身不包含顺序信息,Transformer引入了位置编码(Positional Encoding)来注入序列顺序。同时,残差连接与层归一化保证了深层网络的训练稳定性。这些工程细节共同构成了Transformer注意力机制可靠落地的基础。
3. 从BERT到GPT:注意力机制的规模化应用
基于Transformer的BERT采用双向编码器结构,在信息检索、文本分类、语义匹配等任务中表现优异;GPT系列则采用自回归解码器结构,推动了大语言模型的爆发。在信息传输与互联网服务行业,这些技术被广泛用于智能客服、内容推荐、日志分析与知识库检索等场景。
三、注意力机制的家族谱系:从Soft Attention到稀疏与线性注意力
注意力机制并非单一技术,而是一个不断演化的技术家族。理解其分支有助于在实际项目中做出合理选型。
- 软注意力与硬注意力:软注意力对所有位置分配连续权重,可微可训练;硬注意力则进行离散选择,常用于强化学习场景。
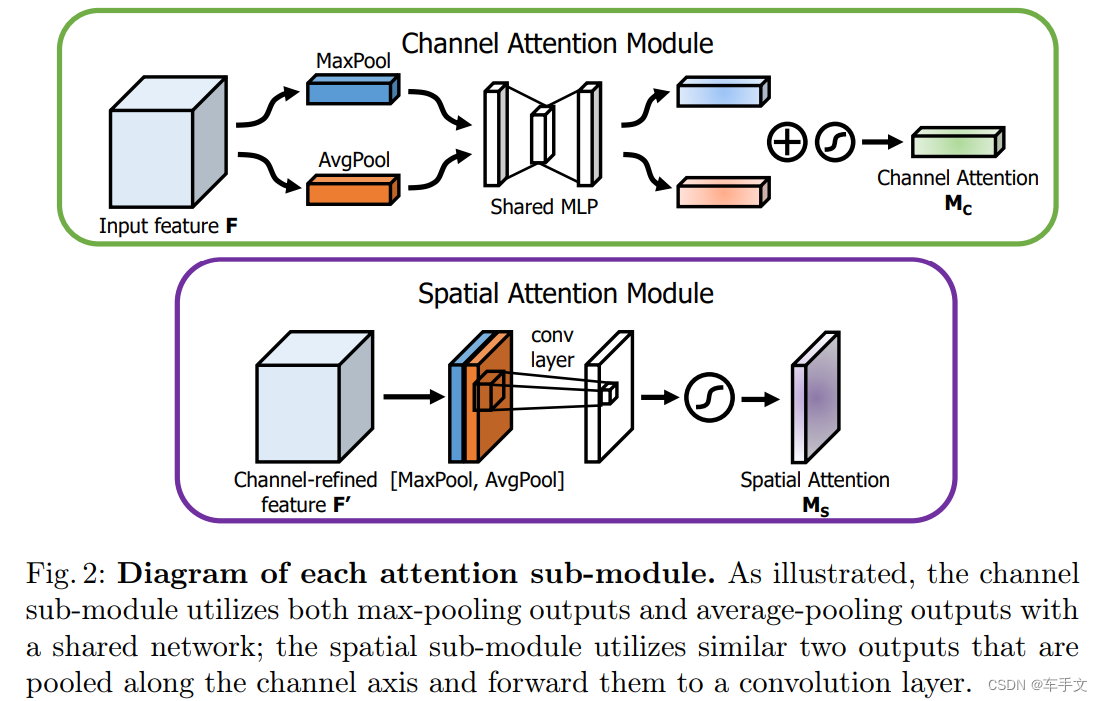
- 通道注意力与空间注意力:在计算机视觉中,SE模块、CBAM等通过通道与空间维度上的注意力加权,显著提升图像识别精度。
- 稀疏注意力与线性注意力:面对长序列带来的平方级计算复杂度,稀疏注意力、Linformer、Performer等方法通过近似或稀疏化降低开销,适用于大规模信息检索与日志处理系统。
- 交叉注意力:在机器翻译、图文匹配、多模态融合中,交叉注意力让解码器聚焦于编码器的相关部分,是跨模态信息对齐的关键。
四、注意力机制与元学习算法、强化学习的交叉融合
注意力机制的价值不仅体现在监督学习中。在元学习算法领域,注意力被用于快速适应新任务:模型通过注意力对支撑集样本进行加权,从而在少量样本下实现快速泛化。这类思路在少样本分类、个性化推荐中具有实用价值。
在强化学习方向,注意力机制帮助智能体在复杂状态空间中筛选关键观测信息。例如在无人机仿真平台中,智能体需要同时处理多传感器数据,注意力网络能够动态聚焦于障碍物、目标位置等关键线索,提升决策效率与飞行安全性。AirSim仿真等工具为这类研究提供了高保真的验证环境,使得算法从仿真到真机的迁移更加可靠。
五、典型应用场景:从信息检索到行业技术服务
结合信息传输、软件和信息技术服务业的实际需求,注意力机制已在多个方向落地:
- 信息检索技术:基于Transformer的语义检索模型取代传统关键词匹配,提升搜索相关性;注意力机制用于查询与文档的交互建模,改善排序质量。
- 智能客服与知识库:通过注意力对用户问题与知识条目进行语义对齐,提高问答准确率。
- 系统集成与运维:对海量日志与监控数据进行注意力加权分析,辅助异常检测与根因定位。
- 计算机视觉与无人机仿真:视觉注意力用于目标检测与跟踪,配合AirSim仿真平台完成算法验证。
- 大数据与云计算平台:在推荐系统、用户行为预测中,注意力机制帮助模型聚焦高价值特征,提升服务效果。
六、深度学习入门学习路径:如何系统掌握注意力机制
对于希望进入人工智能领域的开发者,建议按照"基础—框架—实战—拓展"的路径循序渐进:
- 夯实计算机科学基础:线性代数、概率论、微积分与Python编程是必备前提。
- 理解深度学习入门知识:掌握神经网络、反向传播、优化器等核心概念。
- 动手实现注意力模块:从NumPy手写缩放点积注意力开始,再用PyTorch复现多头注意力。
- 参考Fast.ai教程:Fast.ai以自顶向下的教学方式著称,适合快速建立工程直觉并完成端到端项目。
- 进入强化学习与仿真实践:结合AirSim仿真平台与无人机仿真平台,将注意力机制应用于决策与控制任务。
- 持续跟进前沿:关注稀疏注意力、线性注意力、多模态注意力等方向的最新进展。
七、实践建议与常见误区
在工程落地中,注意力机制并非"万能药"。以下几点值得注意:
- 注意力权重可视化并不等于可解释性,需结合其他分析手段综合判断;
- 长序列场景下应评估计算复杂度,必要时采用稀疏或线性近似方案;
- 小数据集上过度堆叠注意力模块容易过拟合,应配合正则化与数据增强;
- 在系统集成项目中,需关注模型推理延迟与部署成本,合理选择模型规模。
注意力机制作为现代深度学习的核心构件,其影响力已经渗透到信息传输、软件开发、大数据分析、人工智能技术服务等各个层面。掌握其原理并具备工程实践能力,是计算机科学从业者在智能时代保持竞争力的重要基础。创智数据科技将持续围绕注意力机制、Transformer架构、元学习算法与仿真平台等方向,为开发者和企业提供技术内容与解决方案支持,助力更多团队在人工智能应用落地中少走弯路。