在信息传输、软件和信息技术服务业高速迭代的今天,人工智能与大数据已成为推动技术服务升级的核心引擎。无论是搜索引擎的精准排序、推荐系统的个性化匹配,还是无人机仿真平台中的实时决策,背后都离不开一项关键技术——注意力机制。本文将从计算机科学基础出发,系统梳理注意力机制的原理、Transformer 架构、元学习算法的结合方式,并延伸到信息检索技术、AirSim 仿真与强化学习等实际应用场景,为深度学习入门者提供一份完整的学习地图。
为什么注意力机制成为深度学习的核心范式
传统的循环神经网络(RNN)和卷积神经网络(CNN)在处理长序列时,往往面临信息衰减、并行效率低等问题。注意力机制的提出,让模型能够"动态聚焦"于输入序列中与当前任务最相关的部分,从根本上改变了序列建模的思路。
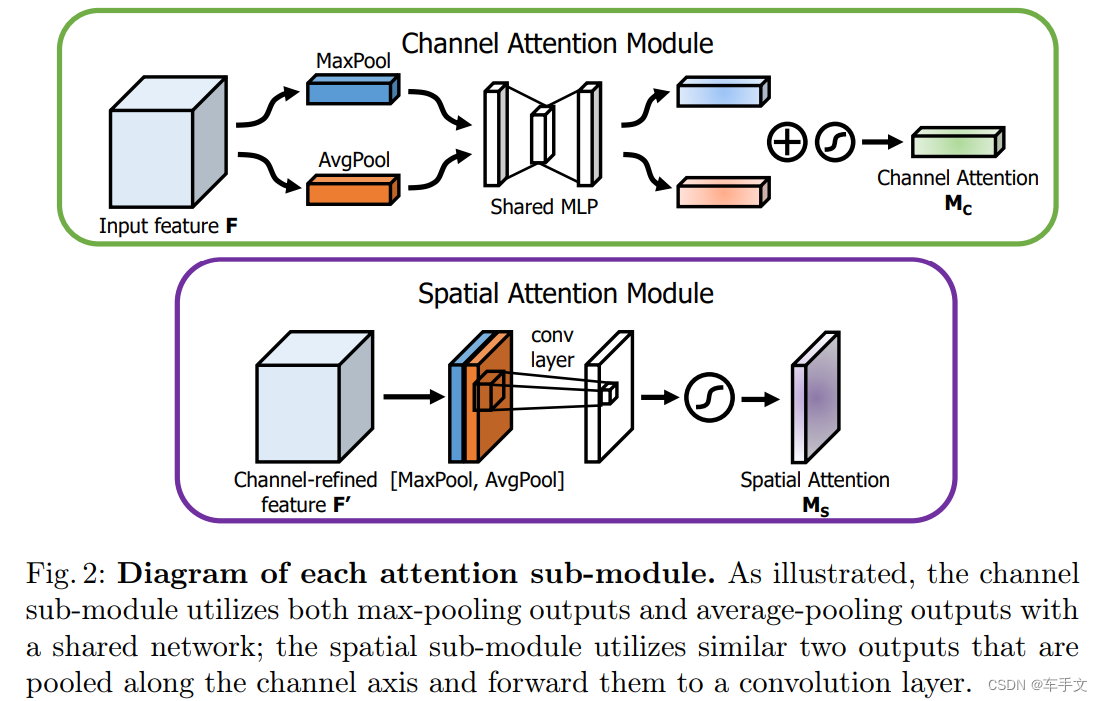
从信息传输的角度看,注意力机制本质上是一种加权信息路由:模型不再被动地逐点传递信息,而是主动判断"哪些信息值得关注、以多大权重关注"。这种机制与互联网、电信网络中的路由调度、大数据平台中的特征选择,在思想上有高度的一致性。
- 并行计算友好:摆脱时序依赖,充分利用 GPU 算力。
- 长距离依赖建模:任意两个位置可直接建立关联,缓解梯度消失。
- 可解释性增强:注意力权重可视化,帮助理解模型决策依据。
- 跨模态通用:文本、图像、语音、点云均可统一建模。
Transformer 注意力机制:从自注意力到多头结构
Transformer 是注意力机制最成功的工程化落地。它完全抛弃了循环结构,仅依靠自注意力(Self-Attention)和前馈网络堆叠而成,成为当今大模型的基础骨架。
1. 自注意力的计算逻辑
自注意力通过 Query、Key、Value 三个矩阵,计算序列中每个位置对其他位置的关注程度。核心公式为:
Attention(Q, K, V) = softmax(QKᵀ / √dk) · V
其中 √dk 用于缩放,避免点积过大导致 softmax 梯度饱和。这一设计看似简单,却让模型具备了全局感知能力。
2. 多头注意力(Multi-Head Attention)
单一注意力头只能捕捉一种关联模式。多头注意力将 Q、K、V 投影到多个子空间并行计算,再拼接输出,使模型能同时关注语法结构、语义关系、位置信息等不同维度的特征。
3. 位置编码与残差连接
由于没有循环结构,Transformer 需要位置编码(Positional Encoding)注入顺序信息;残差连接与层归一化则保证深层网络的稳定训练。这些工程细节,是 Transformer 注意力机制能够扩展到数十亿参数的关键。
注意力机制与元学习算法的协同
元学习算法(Meta-Learning)关注"学会学习",即让模型在少量样本下快速适应新任务。将注意力机制引入元学习,可以显著提升任务适应的效率。
- 任务注意力:在多个子任务间动态分配注意力权重,实现任务间的知识迁移。
- 记忆增强:结合外部记忆模块,注意力用于检索历史任务中最相关的经验。
- 少样本分类:在原型网络、匹配网络中,注意力帮助度量样本间的相似性。
对于从事系统集成、智能运维、安全检测的技术团队而言,元学习 + 注意力机制的组合,意味着模型可以更快适配新场景、新数据分布,降低反复训练的成本。
注意力机制在信息检索技术中的应用
信息检索技术是注意力机制最早、最成熟的应用领域之一。从传统 BM25 到神经检索模型,注意力机制带来了检索质量的质变。
查询-文档交互建模
在深度语义匹配中,注意力机制用于建模查询词与文档词之间的交互关系,判断哪些文档片段真正回应了用户意图。交叉注意力(Cross-Attention)让查询与文档双向对齐,显著提升相关性排序效果。
向量检索与语义召回
基于 Transformer 编码的稠密向量,配合近似最近邻搜索,可在海量数据中实现毫秒级语义召回。这一技术已广泛应用于搜索引擎、企业知识库、电商推荐等场景。
重排序与摘要生成
在召回之后,注意力模型对候选结果进行精细重排;在结果呈现阶段,注意力机制驱动的生成模型还能自动生成摘要,帮助用户快速理解内容。
AirSim 仿真与强化学习中的注意力实践
无人机仿真平台 AirSim 为强化学习研究提供了高保真环境。在无人机自主导航、避障、目标跟踪等任务中,注意力机制发挥着重要作用。
- 视觉注意力:从高维图像中聚焦关键区域,如障碍物、目标、跑道标识。
- 时序注意力:在历史观测序列中提取对当前决策最有价值的状态。
- 多传感器融合:对视觉、IMU、激光雷达等异构数据进行注意力加权融合。
- 策略泛化:结合元学习算法,让策略快速适应新环境与新任务。
对于希望入门强化学习与仿真开发的工程师,建议先在 AirSim 中搭建简单场景,逐步引入注意力模块,观察其对收敛速度与策略稳定性的影响。
深度学习入门:如何系统学习注意力机制
面对庞杂的知识体系,初学者常感到无从下手。以下是一条较为务实的进阶路径,也适用于 Fast.ai 教程等实战导向的学习方式。
第一阶段:夯实计算机科学基础
- 线性代数、概率论、微积分的基本概念。
- Python 编程与 NumPy、PyTorch 基础操作。
- 神经网络基本原理:前向传播、反向传播、损失函数。
第二阶段:动手实现注意力
- 从零实现 Scaled Dot-Product Attention。
- 搭建单头与多头注意力模块。
- 复现一个迷你 Transformer,完成简单翻译或分类任务。
第三阶段:结合实战项目
- 使用 Fast.ai 教程快速上手迁移学习与文本分类。
- 在信息检索任务中实践语义匹配与向量召回。
- 在 AirSim 仿真中训练带注意力模块的强化学习智能体。
常见问题与工程落地建议
在实际项目中引入注意力机制,需要注意以下几点:
- 计算成本:标准自注意力复杂度为 O(n²),长序列场景可考虑稀疏注意力、线性注意力等变体。
- 数据质量:注意力机制对噪声敏感,数据清洗与特征工程依然重要。
- 模型规模:并非越大越好,需结合业务场景与算力预算权衡。
- 可解释性:善用注意力可视化,辅助调试与业务沟通。
- 工程化部署:结合云计算与容器化技术,实现模型的弹性伸缩与稳定运维。
结语
注意力机制已从一篇学术论文中的创新想法,成长为支撑人工智能、大数据、信息检索、无人机仿真等诸多领域的基础设施。对于信息传输、软件和信息技术服务业的从业者而言,理解注意力机制不仅是掌握一项技术,更是理解当代智能系统如何"选择信息、分配资源、做出决策"的关键视角。无论你是刚踏入深度学习入门阶段,还是正在探索元学习算法与强化学习的前沿应用,注意力机制都值得投入时间深入钻研。
创智数据科技将持续分享计算机科学基础、Transformer 注意力机制、信息检索技术、AirSim 仿真等方向的实战内容,助力技术团队在智能化转型中走得更稳、更远。