在深度学习快速演进的今天,注意力机制(Attention Mechanism)已经成为推动人工智能突破的关键技术之一。从机器翻译到图像识别,从语音处理到多模态大模型,注意力机制几乎无处不在。对于希望深入理解现代AI架构的开发者而言,掌握注意力机制不仅是入门深度学习的重要一步,更是通向Transformer、大语言模型等高阶技术的必经之路。本文将系统梳理注意力机制的核心原理、典型变体、应用场景与学习路径,帮助读者建立完整的知识框架。
什么是注意力机制:让模型学会“聚焦”
注意力机制的核心思想非常直观:当人类观察一幅画面或阅读一段文字时,并不会平均地处理所有信息,而是有选择地聚焦于关键部分。深度学习中的注意力机制正是模拟这一过程,让模型在处理输入数据时,能够动态地为不同部分分配不同的权重。
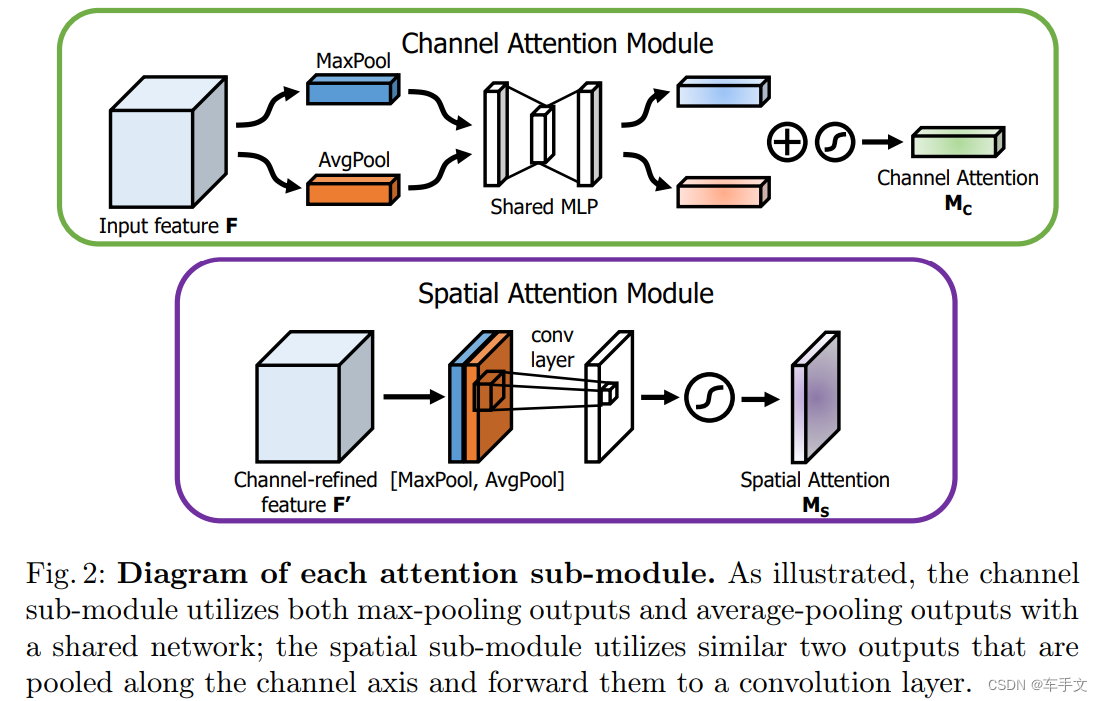
在传统神经网络中,输入信息往往被同等对待,这导致模型难以从长序列或复杂数据中提取重点。而注意力机制通过计算查询(Query)、键(Key)和值(Value)之间的相关性,生成一组权重,从而对信息进行加权聚合。这种机制使模型具备了“选择性关注”的能力,显著提升了表达能力和泛化性能。
- Query(查询):表示当前需要关注的目标信息。
- Key(键):表示输入数据中可供匹配的特征。
- Value(值):表示实际被加权聚合的内容。
- 注意力权重:通过Query与Key的相似度计算得到,用于加权Value。
Transformer注意力机制:现代AI架构的基石
2017年,谷歌团队在论文《Attention Is All You Need》中提出了Transformer架构,彻底改变了序列建模的范式。Transformer完全摒弃了循环和卷积结构,仅依靠自注意力机制(Self-Attention)完成信息建模,实现了更高的并行效率和更强的长距离依赖捕捉能力。
Transformer注意力机制的核心是多头自注意力(Multi-Head Self-Attention)。它通过多个独立的注意力头,从不同子空间学习输入序列的内部关系,最终将各头结果拼接并线性变换。这种设计使模型能够同时关注语法、语义、位置等多种维度的信息。
Transformer注意力机制的优势主要体现在以下几个方面:
- 并行计算能力强:不依赖时间步递归,训练效率大幅提升。
- 长距离依赖建模好:任意两个位置之间的交互路径为常数级。
- 可扩展性高:易于堆叠成深层网络,支撑大模型训练。
- 通用性强:可应用于自然语言处理、计算机视觉、语音识别等多个领域。
如今,BERT、GPT、ViT、LLaMA等主流模型均以Transformer注意力机制为核心组件。可以说,不理解注意力机制,就无法真正理解现代人工智能。
注意力机制的主要变体与演进方向
随着研究深入,注意力机制衍生出多种变体,以适应不同任务和计算资源约束。以下是几类常见的注意力机制形式:
- 加性注意力(Additive Attention):早期用于神经机器翻译,通过前馈网络计算相似度。
- 点积注意力(Dot-Product Attention):计算高效,是Transformer的基础形式。
- 多头注意力(Multi-Head Attention):并行多个注意力头,增强表示能力。
- 交叉注意力(Cross-Attention):用于编码器-解码器结构,实现跨序列信息交互。
- 稀疏注意力(Sparse Attention):降低计算复杂度,适用于超长序列。
- 线性注意力(Linear Attention):将复杂度降至线性,提升推理效率。
这些变体在不同场景下各有优势。例如,在无人机仿真平台和AirSim仿真环境中,注意力机制可用于视觉目标跟踪与路径规划;在信息检索技术中,注意力机制能够提升查询与文档的语义匹配精度。
注意力机制与元学习算法的结合
元学习算法(Meta-Learning)旨在让模型“学会学习”,即通过少量样本快速适应新任务。将注意力机制引入元学习,可以显著提升模型对任务特征的提取与适应能力。
例如,在少样本分类任务中,注意力机制可以帮助模型聚焦于支持集中与查询样本最相关的特征区域,从而做出更准确的预测。这种结合在智能推荐、个性化服务、边缘计算等场景中具有广阔应用前景。
对于从事故障诊断、系统集成、运维安全等信息技术服务的企业而言,注意力机制与元学习的融合也意味着更智能的日志分析、异常检测和自动化决策能力。
如何系统学习注意力机制:从基础到实战
想要真正掌握注意力机制,建议按照以下路径循序渐进:
- 夯实计算机科学基础:理解线性代数、概率论、微积分与神经网络基本原理。
- 深度学习入门:熟悉PyTorch或TensorFlow,掌握全连接、卷积、循环网络。
- 强化学习基础:了解策略梯度、价值函数,为理解决策类注意力应用打基础。
- 动手实现注意力模块:从Scaled Dot-Product Attention写起,逐步实现多头注意力。
- 参考Fast.ai教程:Fast.ai提供了大量实战导向的深度学习课程,适合快速上手。
- 结合仿真平台实践:在AirSim仿真或无人机仿真平台中验证注意力模型效果。
- 阅读经典论文与源码:精读《Attention Is All You Need》,并复现Transformer。
学习过程中,建议将理论推导与代码实现紧密结合。只有亲手实现过注意力计算、位置编码、残差连接等模块,才能真正理解其设计精髓。
注意力机制的典型应用场景
注意力机制已渗透到信息传输、软件服务、人工智能等多个行业。以下是一些典型应用:
- 机器翻译与文本生成:提升长句翻译质量与上下文连贯性。
- 信息检索技术:优化搜索引擎排序,实现语义级匹配。
- 计算机视觉:用于图像分类、目标检测、图像描述生成。
- 语音识别:对齐音频与文本,提高识别准确率。
- 推荐系统:捕捉用户历史行为中的关键兴趣点。
- 无人机仿真平台:辅助视觉导航与自主决策。
- 大数据与云计算:用于日志分析、异常检测与资源调度。
在信息技术服务领域,注意力机制还可以与系统集成、运维安全、平台开发相结合,构建更智能的自动化运维与安全防护体系。
未来趋势:注意力机制的下一站
随着大模型规模持续扩大,注意力机制也面临计算复杂度高、内存占用大等挑战。未来的研究方向包括:
- 高效注意力:降低复杂度,支持超长上下文。
- 可解释注意力:提升模型透明度与可控性。
- 多模态注意力:融合文本、图像、语音等多种信息。
- 注意力与强化学习结合:用于复杂决策与智能控制。
- 边缘端部署:轻量化注意力模型,适配移动与嵌入式设备。
可以预见,注意力机制仍将是人工智能发展的核心驱动力之一。对于开发者和企业而言,尽早建立注意力机制的知识体系,意味着在智能化转型中占据先机。
结语
注意力机制不仅是一项技术,更是一种让模型“懂得取舍”的设计哲学。从Transformer注意力机制到元学习算法,从信息检索技术到AirSim仿真与无人机仿真平台,注意力机制正在重塑信息传输、软件服务与人工智能的各个层面。希望本文能帮助你建立清晰的认知框架,并在深度学习入门与实战道路上走得更稳、更远。